Растущее значение лингвистики в больших языковых моделях
По мере развития больших языковых моделей многие проблемы, связанные со значением, контекстом и интерпретацией, всё чаще возвращают нас к вопросам, которые давно изучает лингвистика, что делает эту дисциплину необходимой основой для понимания как возможностей, так и ограничений языковых систем на базе искусственного интеллекта.
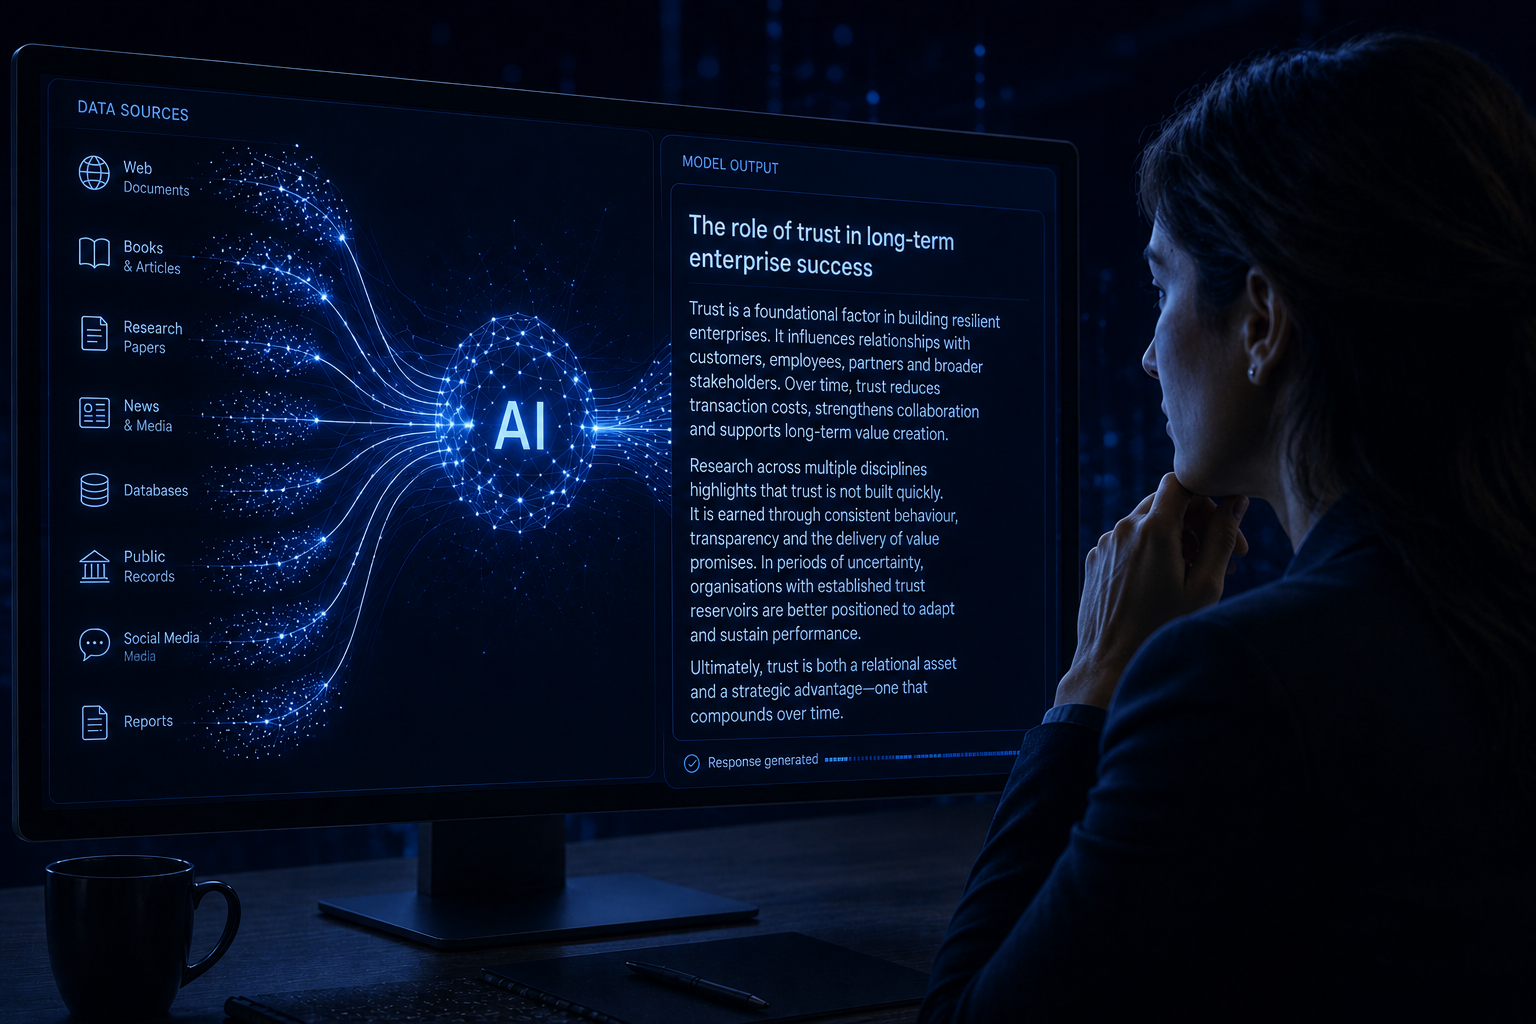
Большие языковые модели (LLM), такие как ChatGPT, всё сильнее влияют не только на то, какая информация выводится на первый план, но и на то, как в цифровой среде формируются достоверность и авторитет. По мере того как поиск с помощью искусственного интеллекта всё глубже проникает в повседневные задачи, управление репутацией также должно адаптироваться к этому сдвигу.
Большие языковые модели относятся к более широкой области обработки естественного языка (NLP), дисциплины, которая стремится научить машины обрабатывать и порождать человеческий язык. Однако, несмотря на растущее влияние, эти системы часто называют «чёрными ящиками»: непрозрачными технологиями, внутренние процессы принятия решений в которых всё ещё трудно интерпретировать. Их результаты носят вероятностный, а не основанный на правилах характер и формируются на основе закономерностей, усвоенных из огромных массивов данных, а не с помощью фиксированных структур рассуждения.
Организации нередко взаимодействуют с искусственным интеллектом преимущественно на уровне пользовательского интерфейса, сосредотачиваясь на запросах, результатах и поверхностных методах взаимодействия, таких как составление промптов, и уделяя гораздо меньше внимания глубинным процессам и архитектурам, которые формируют эти системы. Хотя такие приёмы могут давать постепенные улучшения, они редко затрагивают более глубокие механизмы, посредством которых формируется смысл и генерируются ответы. Чтобы понять этот процесс, нужна иная перспектива: основанная не только на технологиях, но и на самом языке.
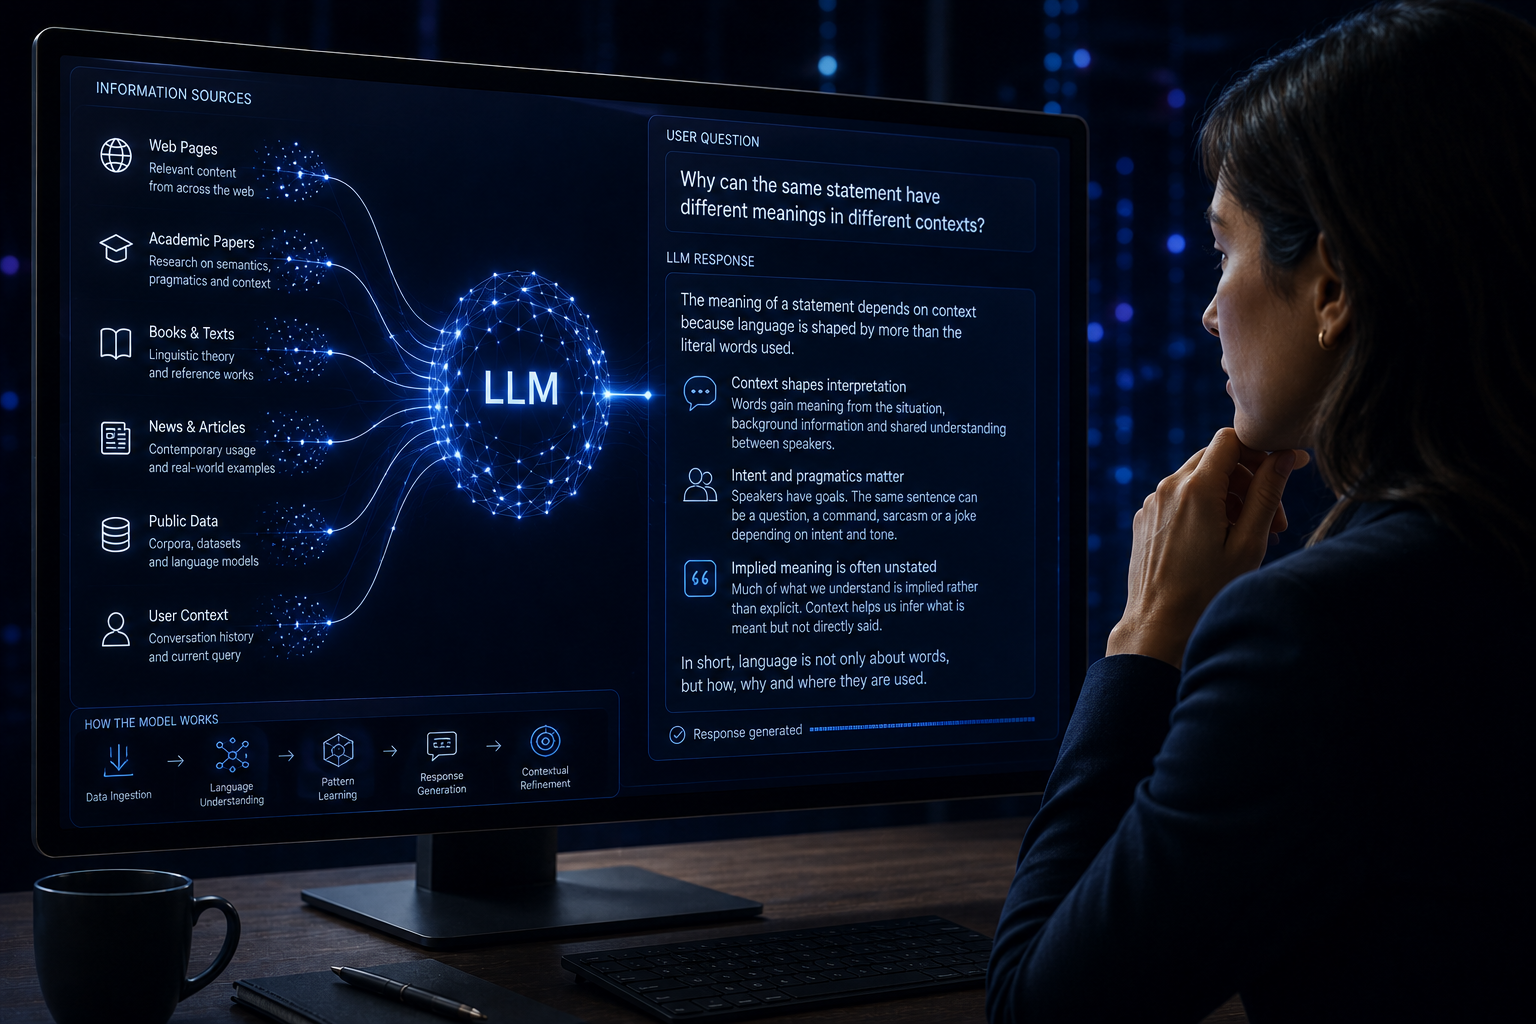
По своей сути большие языковые модели работают, предсказывая языковые последовательности на основе усвоенных связей между значением, контекстом и структурой. У этого метода есть свои плюсы и минусы. Эти модели весьма эффективно порождают беглый и связный текст, однако они также могут неверно истолковывать нюансы, упускать имплицитный смысл или генерировать ответы, которые выглядят структурно убедительными, но при этом расходятся с намерением. Эти ограничения не случайны. Они тесно соотносятся с давно сложившимися областями лингвистических исследований.
Семантика, например, изучает, как значение конструируется и представляется в языке. Большие языковые модели приближаются к семантическому пониманию за счёт статистических связей между словами и фразами, но не обладают подлинным пониманием в человеческом смысле. В результате они могут выдавать правдоподобные, но порой неточные, поверхностные или контекстуально неполные ответы. Прагматика, в свою очередь, исследует, как значение меняется в зависимости от контекста, импликации и общего понимания. И здесь большие языковые модели опираются на приближение, что может затруднять интерпретацию тонкостей, зависящих от понимания ситуации или подразумеваемого намерения, а не от явной формулировки.
Понимание этих лингвистических уровней меняет восприятие «чёрного ящика». Вместо того чтобы считать системы искусственного интеллекта совершенно непознаваемыми, их можно рассматривать как структурированные среды, сформированные распознаваемыми лингвистическими закономерностями. Результаты не произвольны; они отражают усвоенные связи между языком, контекстом и вероятностью. Там, где существуют такие закономерности, становится возможной стратегическая интерпретация.
Это имеет важные последствия для управления репутацией. По мере того как ответы, сгенерированные искусственным интеллектом, всё больше определяют, как организации, бренды и люди представлены в интернете, способность понимать эти системы и предвидеть их поведение приобретает стратегическое значение. Тем не менее в отрасли сохраняется явный пробел в знаниях. Хотя многие организации внедряют инструменты искусственного интеллекта, лишь относительно немногие детально понимают, как эти системы выстраивают и воспроизводят информацию. Это создаёт разрыв между использованием и пониманием, вследствие чего взаимодействие с искусственным интеллектом остаётся реактивным, а не стратегическим.
Чтобы преодолеть этот разрыв, необходимо выйти за рамки поверхностного взаимодействия и более непосредственно обратиться к структурам, лежащим в основе самого порождения языка. Обработка естественного языка охватывает широкий круг вычислительных дисциплин, однако в её основе лежит часто недооцениваемый ресурс: лингвистическая теория. Такие области, как компьютерная лингвистика, семантика и прагматика, дают концептуальные инструменты для понимания того, как значение, интерпретация и контекстуальные связи кодируются в языковых системах. Это не отвлечённые академические вопросы; они напрямую связаны с практической работой больших языковых моделей.
Нынешние разработки в области искусственного интеллекта ещё больше укрепляют эту связь. Усилия по оценке и совершенствованию контекстуальных рассуждений, более точному согласованию результатов с намерениями человека и повышению точности интерпретации указывают на задачи, которые лингвистика давно стремится решить. По мере того как системы генеративного искусственного интеллекта развиваются в сторону всё более сложных форм рассуждения и коммуникации, значимость лингвистических подходов, вероятно, станет ещё более заметной.
Для организаций, работающих в среде, опосредованной искусственным интеллектом, этот сдвиг меняет саму природу влияния. Уже недостаточно выстраивать коммуникацию только для человеческой аудитории. Организациям всё чаще приходится учитывать и то, как информация обрабатывается, интерпретируется и воспроизводится системами генеративного искусственного интеллекта. Это не означает прямого контроля над результатами. Скорее, это открывает возможность более стратегически работать со структурами, через которые эти системы порождают смысл и расставляют приоритеты в информации.
В Michael Macfarlane Associates эта перспектива определяет наш подход к репутационной стратегии в среде, управляемой искусственным интеллектом. Понимание лингвистических структур, лежащих в основе результатов больших языковых моделей, позволяет точнее интерпретировать, как информация формируется, выводится на первый план и закрепляется в генеративных системах. По мере того как поиск информации с помощью искусственного интеллекта всё глубже интегрируется в повседневную жизнь, такой уровень понимания становится всё более важным для организаций, стремящихся сохранять достоверность и авторитет в меняющихся цифровых экосистемах.