Kepentingan Linguistik Yang Semakin Meningkat Dalam Model Bahasa Besar
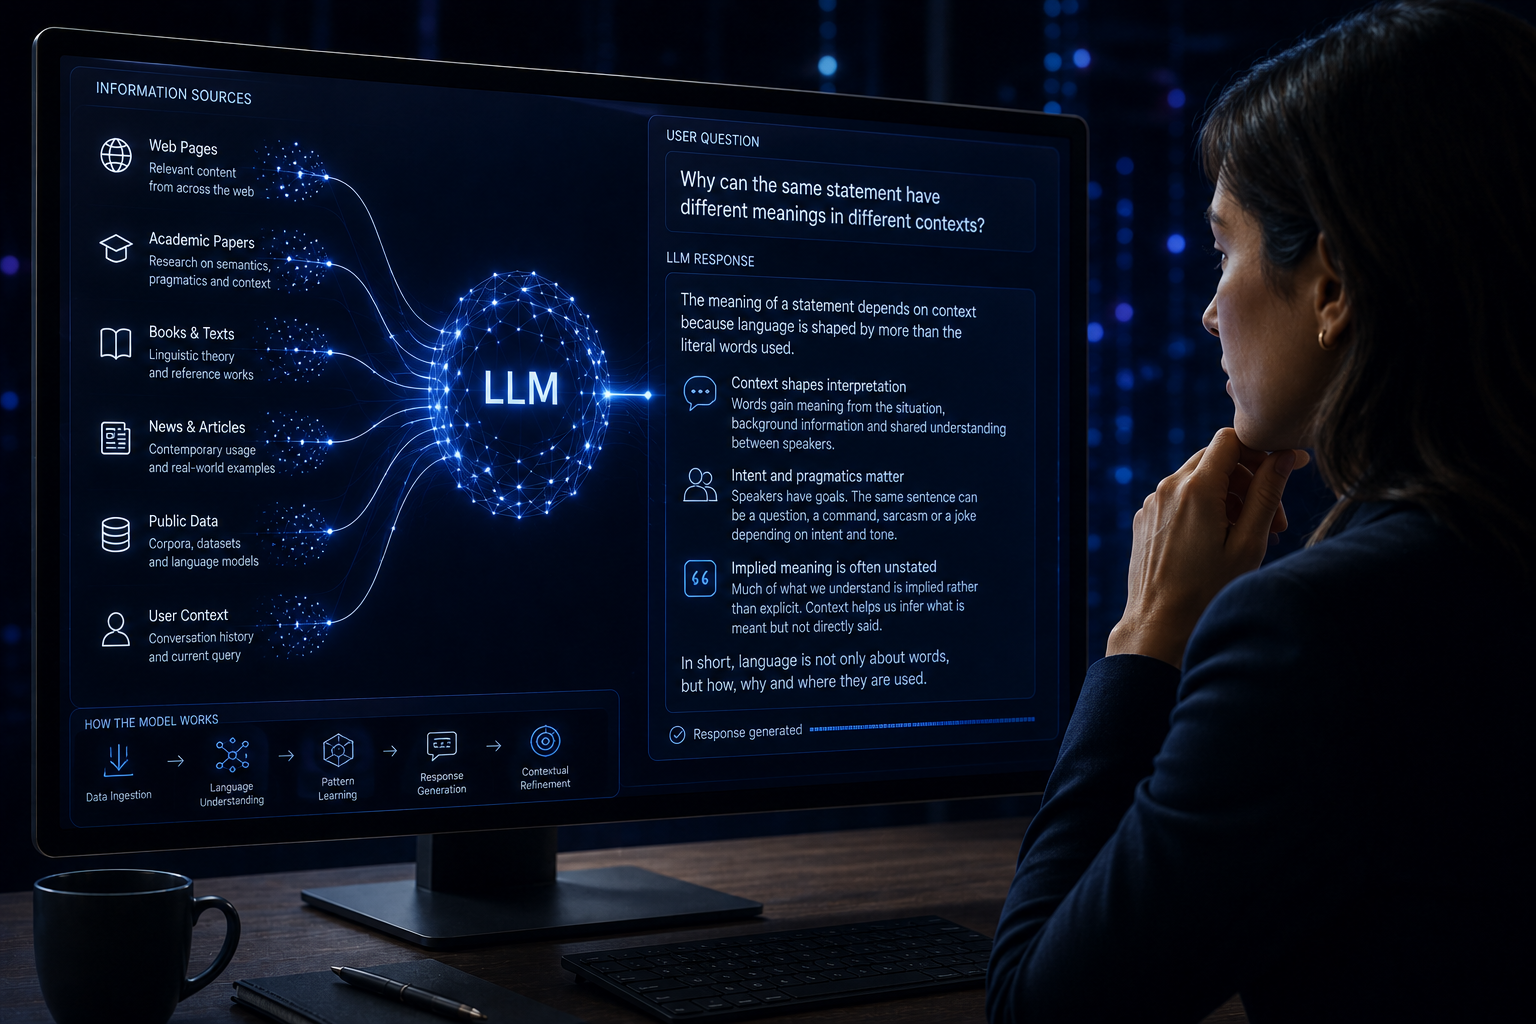
Seiring dengan perkembangan berterusan model bahasa besar, banyak cabaran berkaitan makna, konteks dan tafsiran semakin kembali kepada persoalan yang telah lama dikaji dalam bidang linguistik, sekali gus meletakkan disiplin ini sebagai kerangka penting untuk memahami keupayaan dan batasan sistem bahasa berasaskan kecerdasan buatan.
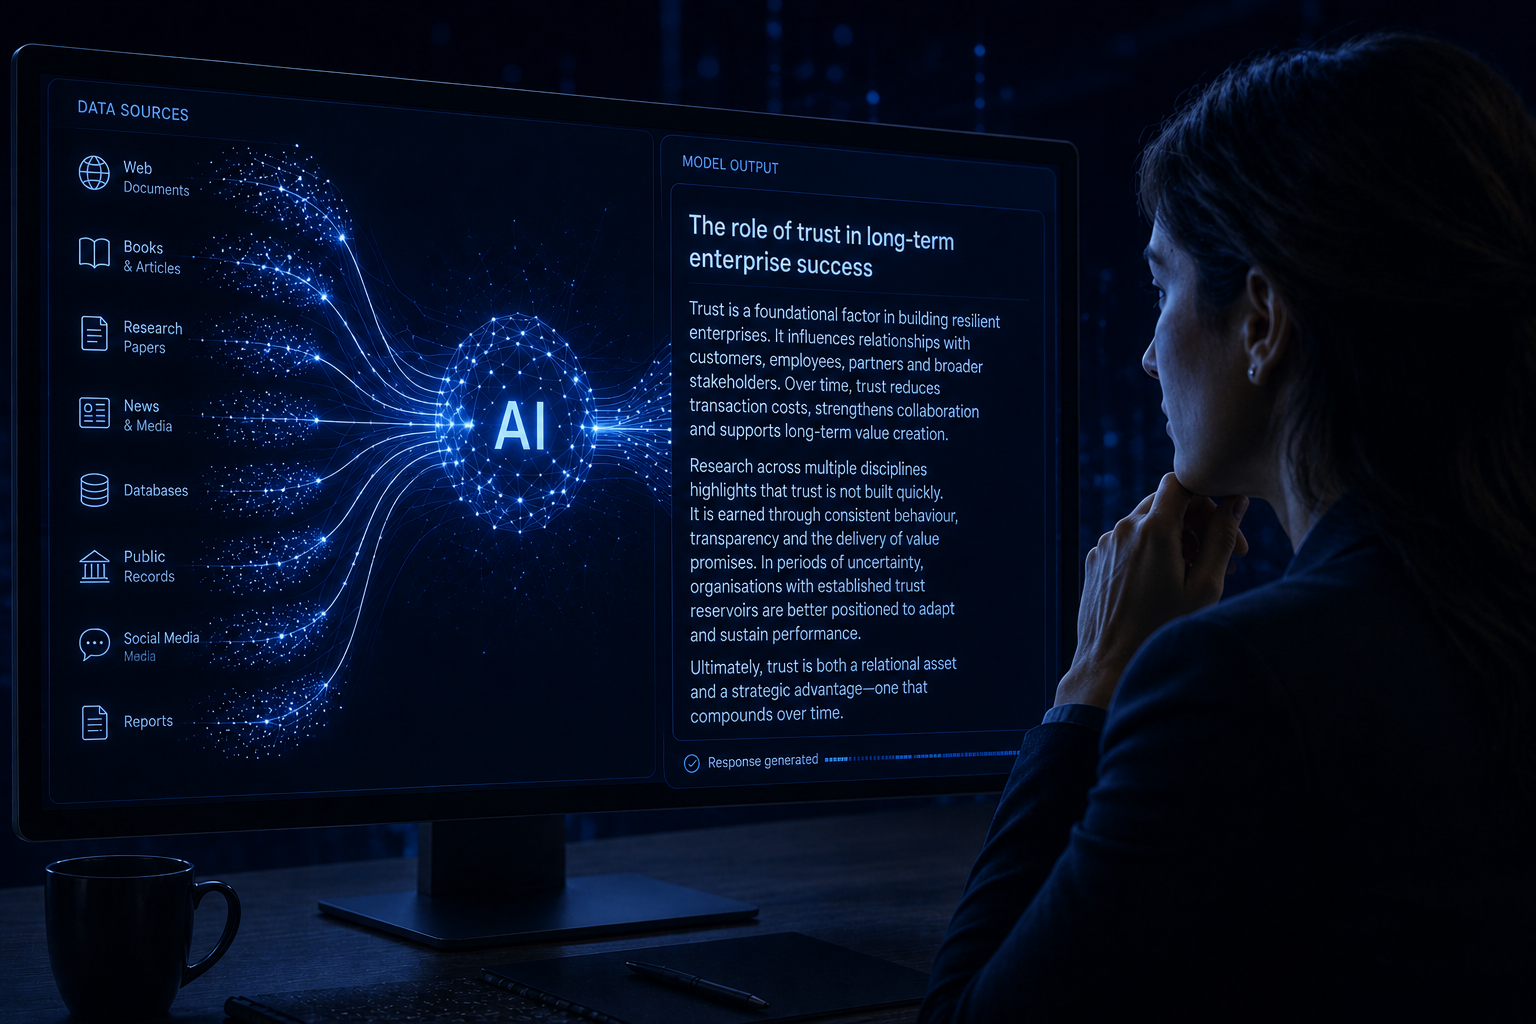
Model bahasa besar (LLM) seperti ChatGPT semakin membentuk bukan sahaja maklumat yang dipaparkan, malah cara kredibiliti dan autoriti dibina dalam persekitaran digital. Apabila carian berbantukan kecerdasan buatan semakin sebati dalam tugasan harian, pengurusan reputasi juga perlu menyesuaikan diri dengan peralihan ini.
LLM terletak dalam bidang Pemprosesan Bahasa Semula Jadi (NLP) yang lebih luas, iaitu disiplin yang bertujuan membolehkan mesin memproses dan menjana bahasa manusia. Namun, walaupun pengaruhnya semakin besar, sistem ini sering digambarkan sebagai “kotak hitam”: teknologi legap yang proses membuat keputusan dalamannya sukar ditafsirkan. Outputnya bersifat kebarangkalian dan bukan berasaskan peraturan, dihasilkan melalui corak yang dipelajari daripada jumlah data yang amat besar dan bukan melalui struktur penaakulan yang tetap.
Organisasi sering berinteraksi dengan kecerdasan buatan terutamanya pada peringkat antara muka pengguna, dengan memberi tumpuan kepada gesaan, output dan kaedah interaksi pada peringkat permukaan seperti kejuruteraan gesaan (prompt engineering), sambil memberikan perhatian yang jauh lebih sedikit kepada proses dan seni bina asas yang membentuk sistem ini. Walaupun teknik ini mungkin menghasilkan penambahbaikan secara beransur, ia jarang menangani mekanisme yang lebih mendalam yang membentuk makna dan menjana respons. Untuk memahami proses itu, perspektif yang berbeza diperlukan: perspektif yang berteraskan bukan sahaja teknologi, tetapi bahasa itu sendiri.
Pada dasarnya, LLM beroperasi dengan meramalkan jujukan linguistik berdasarkan hubungan yang dipelajari antara makna, konteks dan struktur. Kaedah ini mempunyai kelebihan dan kekurangan. Model ini sangat berkesan dalam menghasilkan bahasa yang lancar dan koheren, namun ia juga boleh tersalah tafsir nuansa, terlepas pandang makna tersirat atau menjana respons yang kelihatan meyakinkan dari segi struktur tetapi tidak selari dengan niat sebenar. Batasan ini tidak berlaku secara rawak. Ia berkait rapat dengan bidang kajian linguistik yang telah lama wujud.
Semantik, sebagai contoh, mengkaji cara makna dibina dan diwakili dalam bahasa. LLM menghampiri kefahaman semantik melalui perkaitan statistik antara perkataan dan frasa, tetapi tidak memiliki kefahaman sebenar dalam erti kata manusia. Akibatnya, ia boleh menghasilkan respons yang munasabah tetapi kadangkala tidak tepat, cetek atau tidak lengkap dari segi konteks. Pragmatik pula meneliti bagaimana makna berubah mengikut konteks, implikasi dan kefahaman bersama. Di sini juga LLM bergantung pada anggaran, yang boleh menyebabkan kesukaran mentafsir kehalusan yang bergantung pada kesedaran situasi atau niat tersirat dan bukannya perkataan yang dinyatakan secara jelas.
Memahami lapisan linguistik ini mengubah cara “kotak hitam” tersebut dilihat. Daripada menganggap sistem kecerdasan buatan sebagai sesuatu yang langsung tidak dapat difahami, sistem ini boleh difahami sebagai persekitaran berstruktur yang dibentuk oleh corak linguistik yang dapat dikenal pasti. Outputnya tidak bersifat arbitrari; ia mencerminkan hubungan yang dipelajari antara bahasa, konteks dan kebarangkalian. Apabila corak sedemikian wujud, tafsiran strategik menjadi mungkin.
Ini membawa implikasi yang besar kepada pengurusan reputasi. Apabila respons yang dijana oleh kecerdasan buatan semakin menjadi pengantara dalam cara organisasi, jenama dan individu digambarkan dalam talian, keupayaan untuk memahami dan menjangka sistem ini menjadi penting dari segi strategik. Namun, jurang pengetahuan yang jelas masih wujud dalam sektor ini. Walaupun banyak organisasi menggunakan alat kecerdasan buatan, hanya segelintir yang mempunyai kefahaman terperinci tentang cara sistem ini membina dan menghasilkan semula maklumat. Ini mewujudkan jurang antara penggunaan dengan pemahaman, menjadikan penglibatan dengan kecerdasan buatan bersifat reaktif dan bukannya strategik.
Merapatkan jurang ini memerlukan langkah melangkaui interaksi pada peringkat permukaan dan berurusan secara lebih langsung dengan struktur yang mendasari penjanaan bahasa itu sendiri. Pemprosesan Bahasa Semula Jadi merangkumi pelbagai disiplin pengkomputeran, tetapi asasnya terletak pada satu sumber yang sering kurang dimanfaatkan: teori linguistik. Bidang seperti linguistik pengkomputeran, semantik dan pragmatik menyediakan alat konseptual untuk memahami cara makna, tafsiran dan hubungan kontekstual dikodkan dalam sistem bahasa. Ini bukan persoalan akademik yang abstrak; ia berkait secara langsung dengan operasi praktikal LLM.
Perkembangan semasa dalam bidang kecerdasan buatan mengukuhkan lagi perkaitan ini. Usaha untuk menilai dan menambah baik penaakulan kontekstual, menyelaraskan output dengan lebih rapat dengan niat manusia dan memperhalus ketepatan tafsiran semuanya menunjukkan cabaran yang telah lama cuba ditangani oleh linguistik. Apabila sistem kecerdasan buatan generatif berkembang ke arah bentuk penaakulan dan komunikasi yang semakin canggih, kerelevanan kerangka linguistik berkemungkinan menjadi lebih ketara.
Bagi organisasi yang beroperasi dalam persekitaran yang dipengaruhi oleh kecerdasan buatan, peralihan ini mengubah sifat pengaruh itu sendiri. Tidak lagi memadai untuk membentuk komunikasi semata untuk khalayak manusia. Organisasi kini semakin perlu mempertimbangkan cara maklumat diproses, ditafsir dan dihasilkan semula oleh sistem kecerdasan buatan generatif. Ini tidak bermakna kawalan langsung ke atas output. Sebaliknya, ia membuka kemungkinan untuk bekerja secara lebih strategik dengan struktur yang digunakan oleh sistem ini untuk menjana makna dan mengutamakan maklumat.
Di Michael Macfarlane Associates, perspektif ini membentuk cara kami mendekati strategi reputasi dalam persekitaran yang dipacu oleh kecerdasan buatan. Memahami struktur linguistik yang mendasari output LLM membolehkan tafsiran yang lebih tepat tentang cara maklumat dibentuk, dipaparkan dan diperkukuh merentas sistem generatif. Apabila penemuan berbantukan kecerdasan buatan semakin sebati dalam pencarian maklumat harian, tahap kefahaman ini menjadi semakin penting bagi organisasi yang ingin mengekalkan kredibiliti dan autoriti dalam ekosistem digital yang sentiasa berubah.