La crescente importanza della linguistica nei modelli linguistici di grandi dimensioni
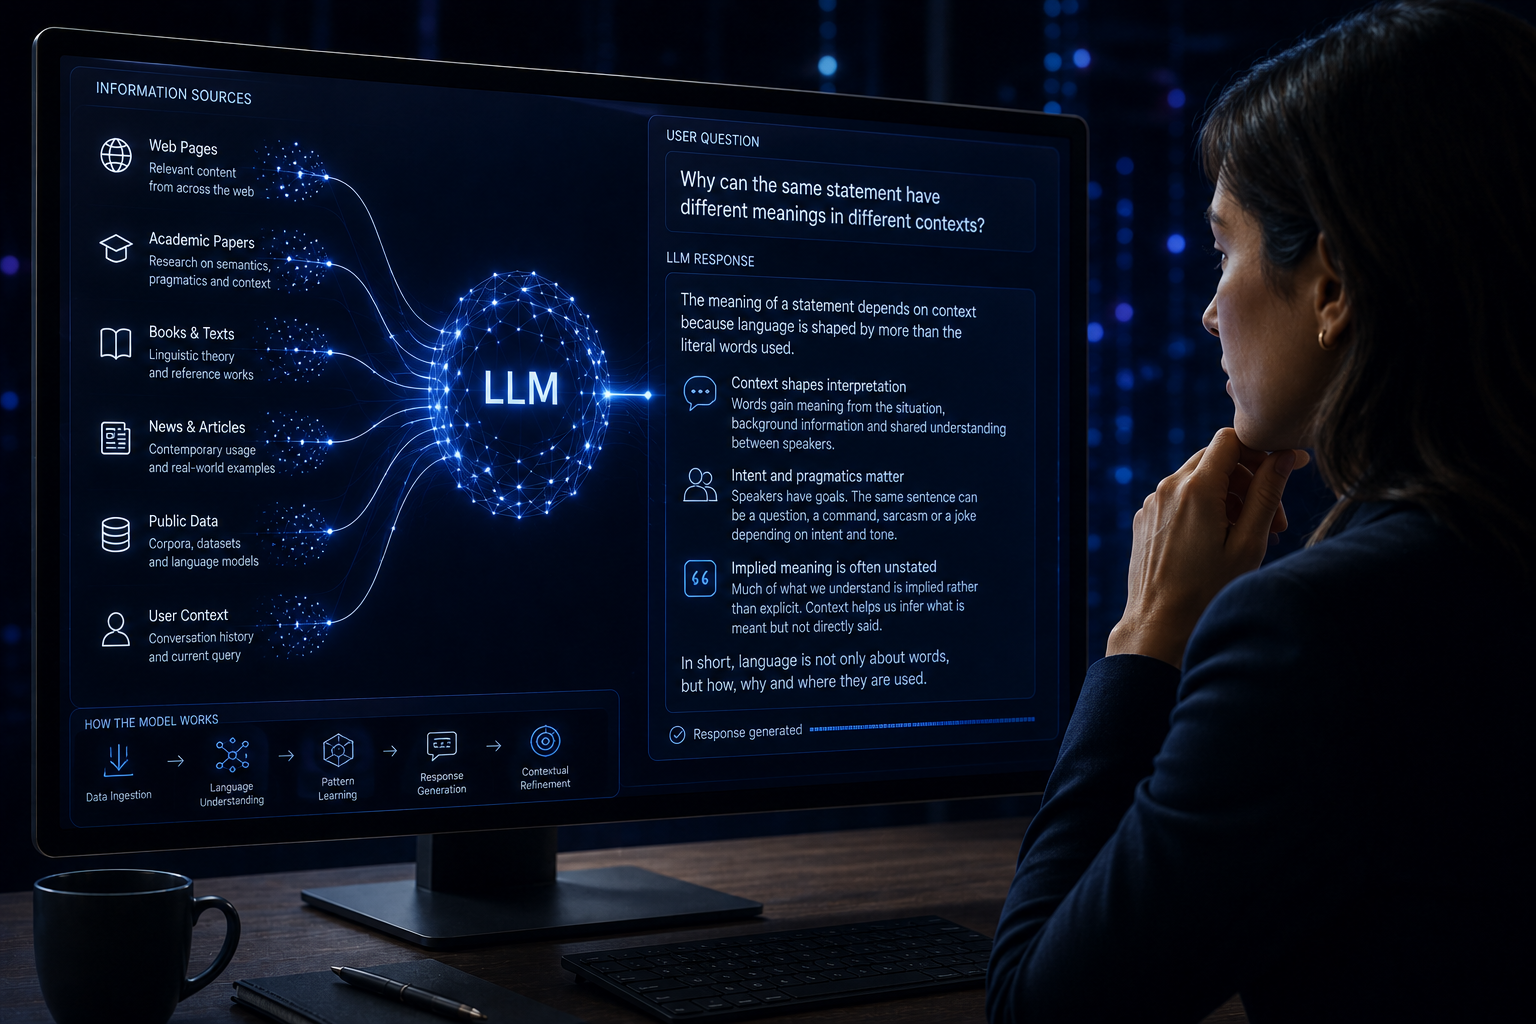
Con la continua evoluzione dei modelli linguistici di grandi dimensioni, molte delle sfide legate a significato, contesto e interpretazione rimandano sempre più a questioni da tempo studiate dalla linguistica, facendo di questa disciplina un quadro di riferimento essenziale per comprendere sia le capacità sia i limiti dei sistemi linguistici basati sull’intelligenza artificiale.
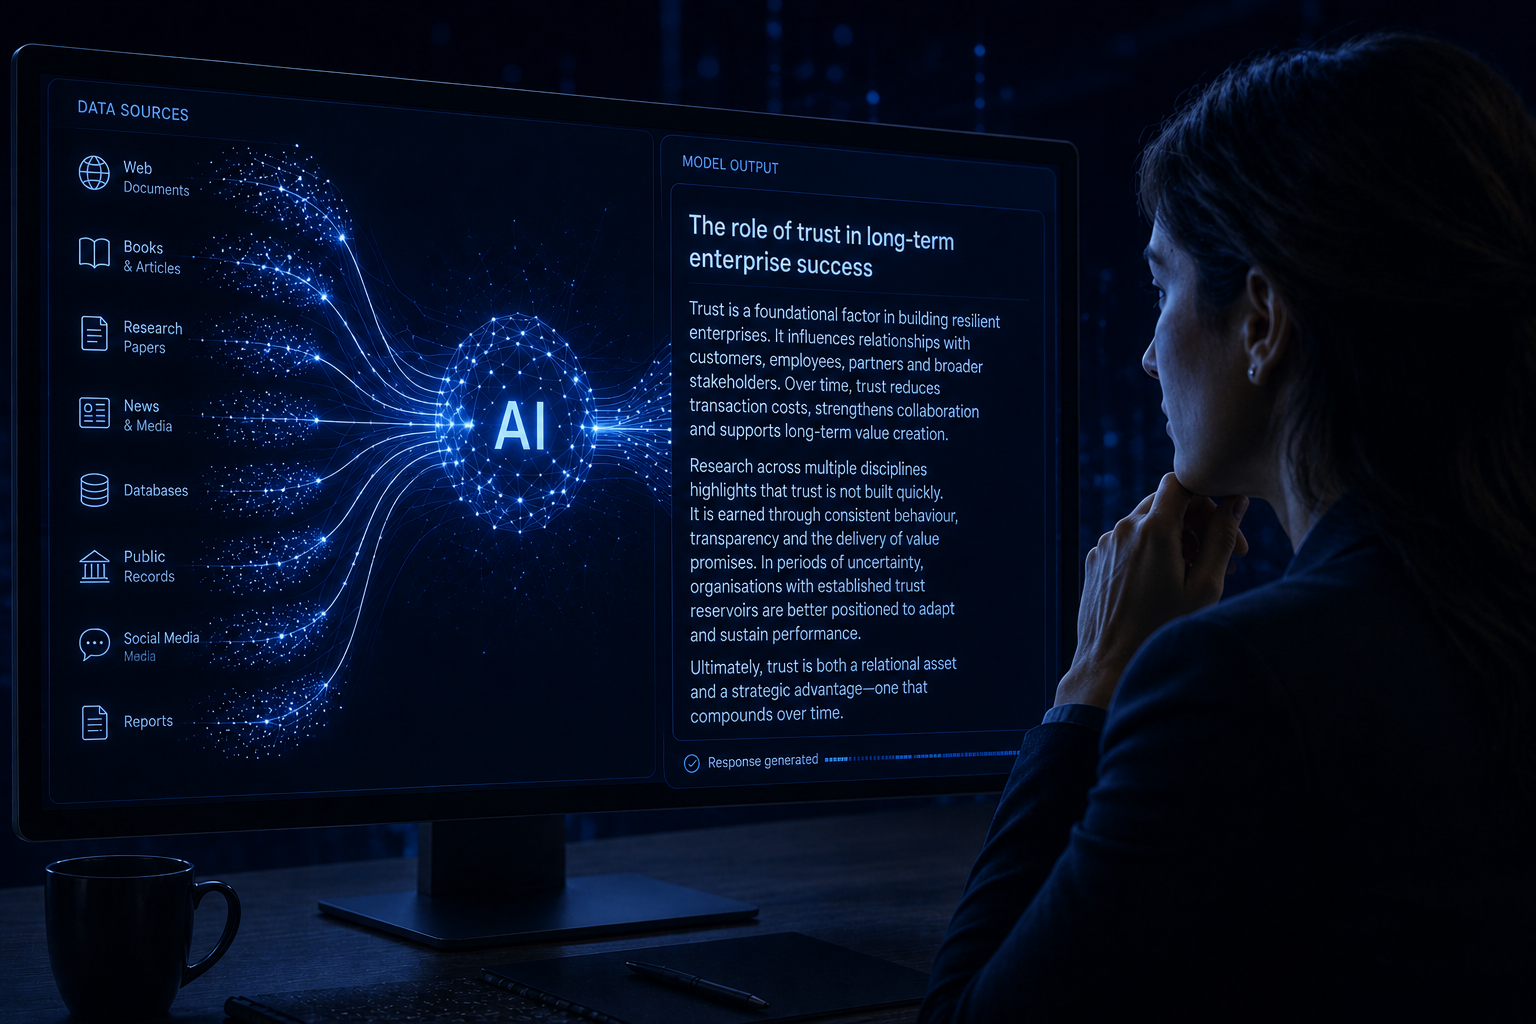
I modelli linguistici di grandi dimensioni (LLM), come ChatGPT, influenzano sempre più non solo quali informazioni vengono messe in evidenza, ma anche il modo in cui credibilità e autorevolezza si costruiscono negli ambienti digitali. Man mano che la ricerca assistita dall’intelligenza artificiale si radica nelle attività quotidiane, anche la gestione della reputazione deve adattarsi a questo cambiamento.
Gli LLM rientrano nel più ampio campo dell’elaborazione del linguaggio naturale (NLP), una disciplina che si occupa di consentire alle macchine di elaborare e generare il linguaggio umano. Eppure, nonostante la loro crescente influenza, questi sistemi vengono spesso descritti come “scatole nere”: tecnologie opache i cui processi decisionali interni restano difficili da interpretare. I loro output sono probabilistici anziché basati su regole, generati attraverso schemi appresi da enormi quantità di dati anziché tramite strutture di ragionamento fisse.
Le organizzazioni si confrontano spesso con l’intelligenza artificiale soprattutto a livello di interfaccia utente, concentrandosi su prompt, output e metodi di interazione superficiali come il prompt engineering, mentre prestano molta meno attenzione ai processi e alle architetture sottostanti che danno forma a questi sistemi. Sebbene queste tecniche possano produrre miglioramenti graduali, raramente affrontano i meccanismi più profondi attraverso cui il significato si forma e le risposte vengono generate. Comprendere questo processo richiede una prospettiva diversa: una prospettiva radicata non soltanto nella tecnologia, ma nel linguaggio stesso.
In sostanza, gli LLM operano prevedendo sequenze linguistiche sulla base di relazioni apprese tra significato, contesto e struttura. Questo metodo presenta pro e contro. Questi modelli sono molto efficaci nel produrre un linguaggio fluido e coerente, ma possono anche fraintendere le sfumature, trascurare i significati impliciti o generare risposte che appaiono strutturalmente convincenti pur restando non allineate all’intento. Questi limiti non sono casuali. Corrispondono strettamente ad ambiti di studio linguistico consolidati da tempo.
La semantica, ad esempio, esplora il modo in cui il significato viene costruito e rappresentato nel linguaggio. Gli LLM approssimano la comprensione semantica attraverso associazioni statistiche tra parole ed espressioni, ma non possiedono una vera comprensione in senso umano. Di conseguenza, possono produrre risposte plausibili ma talvolta imprecise, superficiali o incomplete sul piano del contesto. La pragmatica, invece, esamina come il significato cambi in base al contesto, all’implicazione e alla comprensione condivisa. Anche qui gli LLM si affidano all’approssimazione, il che può rendere difficile interpretare sottigliezze che dipendono dalla consapevolezza della situazione o dall’intento implicito anziché dalla formulazione esplicita.
Comprendere questi livelli linguistici cambia il modo in cui viene percepita la “scatola nera”. Anziché considerare i sistemi di intelligenza artificiale del tutto inconoscibili, li si può intendere come ambienti strutturati, plasmati da schemi linguistici identificabili. Gli output non sono arbitrari; riflettono relazioni apprese tra linguaggio, contesto e probabilità. Laddove esistono tali schemi, diventa possibile un’interpretazione strategica.
Ciò ha implicazioni significative per la gestione della reputazione. Poiché le risposte generate dall’intelligenza artificiale mediano sempre più il modo in cui organizzazioni, marchi e persone vengono rappresentati online, la capacità di comprendere e anticipare questi sistemi diventa strategicamente importante. Tuttavia, nel settore persiste un evidente divario di conoscenze. Sebbene molte organizzazioni stiano adottando strumenti di intelligenza artificiale, relativamente poche possiedono una comprensione approfondita di come questi sistemi costruiscono e riproducono le informazioni. Ciò crea uno scollamento tra utilizzo e comprensione, rendendo il rapporto con l’intelligenza artificiale reattivo anziché strategico.
Colmare questo divario richiede di andare oltre l’interazione superficiale e di confrontarsi più direttamente con le strutture su cui si fonda la generazione del linguaggio stesso. L’elaborazione del linguaggio naturale comprende un’ampia gamma di discipline computazionali, ma alla sua base si trova una risorsa spesso sottoutilizzata: la teoria linguistica. Ambiti come la linguistica computazionale, la semantica e la pragmatica forniscono strumenti concettuali per comprendere come significato, interpretazione e relazioni contestuali vengano codificati nei sistemi linguistici. Non si tratta di questioni accademiche astratte; sono direttamente pertinenti al funzionamento pratico degli LLM.
Gli sviluppi attuali nel campo dell’intelligenza artificiale rafforzano ulteriormente questo legame. Gli sforzi volti a valutare e migliorare il ragionamento contestuale, ad allineare più strettamente gli output all’intento umano e ad affinare l’accuratezza interpretativa rimandano tutti a sfide che la linguistica cerca da tempo di affrontare. Man mano che i sistemi di intelligenza artificiale generativa evolvono verso forme di ragionamento e comunicazione sempre più sofisticate, la rilevanza dei quadri linguistici è destinata a diventare ancora più marcata.
Per le organizzazioni che operano in ambienti mediati dall’intelligenza artificiale, questo cambiamento trasforma la natura stessa dell’influenza. Non basta più plasmare la comunicazione esclusivamente per un pubblico umano. Le organizzazioni devono sempre più considerare anche il modo in cui le informazioni vengono elaborate, interpretate e riprodotte dai sistemi di intelligenza artificiale generativa. Ciò non implica un controllo diretto sugli output. Suggerisce piuttosto la possibilità di lavorare in modo più strategico con le strutture attraverso cui questi sistemi generano significato e stabiliscono le priorità delle informazioni.
In Michael Macfarlane Associates, questa prospettiva orienta il nostro approccio alla strategia reputazionale negli ambienti guidati dall’intelligenza artificiale. Comprendere le strutture linguistiche alla base degli output degli LLM consente un’interpretazione più precisa di come le informazioni si formano, emergono e si consolidano nei sistemi generativi. Man mano che la scoperta assistita dall’intelligenza artificiale si integra sempre più nella ricerca quotidiana di informazioni, questo livello di comprensione diventa sempre più importante per le organizzazioni che intendono mantenere credibilità e autorevolezza all’interno di ecosistemi digitali in evoluzione.