Die wachsende Bedeutung der Linguistik für große Sprachmodelle
Während sich große Sprachmodelle weiterentwickeln, verweisen viele Herausforderungen rund um Bedeutung, Kontext und Interpretation zunehmend auf Fragen, die die Linguistik seit Langem untersucht, wodurch die Disziplin zu einem unverzichtbaren Rahmen wird, um sowohl die Fähigkeiten als auch die Grenzen von Sprachsystemen auf Basis künstlicher Intelligenz zu verstehen.
Große Sprachmodelle (LLMs) wie ChatGPT prägen zunehmend nicht nur, welche Informationen sichtbar werden, sondern auch, wie Glaubwürdigkeit und Autorität in digitalen Umgebungen entstehen. Da die durch künstliche Intelligenz gestützte Suche immer stärker in alltägliche Aufgaben eingebettet ist, muss sich auch das Reputationsmanagement an diesen Wandel anpassen.
LLMs gehören zum umfassenderen Feld der Verarbeitung natürlicher Sprache (NLP), einer Disziplin, die Maschinen in die Lage versetzen soll, menschliche Sprache zu verarbeiten und zu erzeugen. Doch trotz ihres wachsenden Einflusses werden diese Systeme häufig als „Black Boxes“ beschrieben: undurchsichtige Technologien, deren interne Entscheidungsprozesse schwer zu interpretieren bleiben. Ihre Ausgaben sind probabilistisch statt regelbasiert und entstehen aus Mustern, die aus riesigen Datenmengen gelernt wurden, nicht aus festen Denkstrukturen.
Organisationen befassen sich mit künstlicher Intelligenz oft vor allem auf der Ebene der Benutzeroberfläche und konzentrieren sich auf Prompts, Ausgaben und oberflächliche Interaktionsmethoden wie Prompt Engineering, während sie den zugrunde liegenden Prozessen und Architekturen, die diese Systeme prägen, weit weniger Aufmerksamkeit schenken. Solche Techniken mögen schrittweise Verbesserungen bewirken, doch selten berühren sie die tieferen Mechanismen, durch die Bedeutung entsteht und Antworten erzeugt werden. Um diesen Prozess zu verstehen, bedarf es einer anderen Perspektive: einer, die nicht allein in der Technologie, sondern in der Sprache selbst verankert ist.
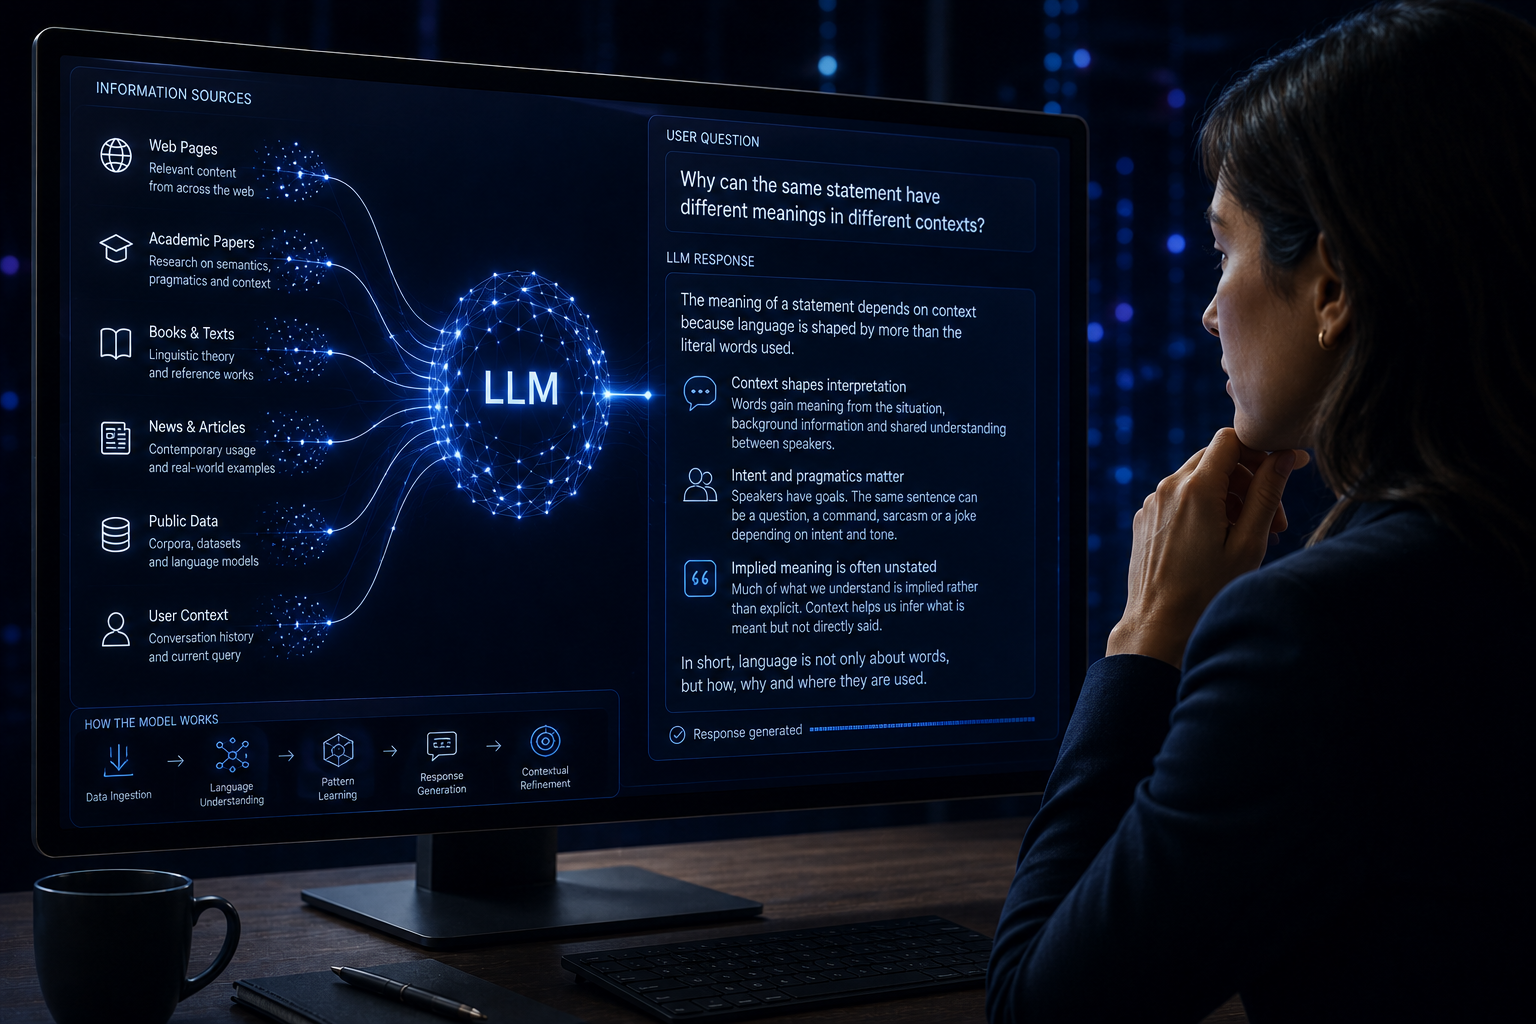
Im Kern arbeiten LLMs, indem sie sprachliche Sequenzen auf Grundlage gelernter Beziehungen zwischen Bedeutung, Kontext und Struktur vorhersagen. Diese Methode hat Vorzüge und Nachteile. Diese Modelle erzeugen sehr wirkungsvoll flüssige, kohärente Sprache, können jedoch auch Nuancen falsch deuten, implizite Bedeutungen übersehen oder Antworten generieren, die strukturell überzeugend wirken, aber an der Absicht vorbeigehen. Diese Einschränkungen sind nicht zufällig. Sie entsprechen eng seit Langem etablierten Bereichen der linguistischen Forschung.
Die Semantik etwa untersucht, wie Bedeutung in der Sprache konstruiert und repräsentiert wird. LLMs nähern sich semantischem Verständnis über statistische Assoziationen zwischen Wörtern und Wendungen an, besitzen jedoch kein echtes Verständnis im menschlichen Sinne. Daher können sie Antworten liefern, die plausibel, mitunter aber ungenau, oberflächlich oder kontextuell unvollständig sind. Die Pragmatik wiederum untersucht, wie sich Bedeutung je nach Kontext, Implikation und geteiltem Verständnis verschiebt. Auch hier stützen sich LLMs auf Annäherung, was zu Schwierigkeiten bei der Deutung von Feinheiten führen kann, die vom Situationsbewusstsein oder von implizierter Absicht statt von expliziter Formulierung abhängen.
Das Verständnis dieser sprachlichen Ebenen verändert, wie die „Black Box“ wahrgenommen wird. Statt Systeme künstlicher Intelligenz als völlig unergründlich zu betrachten, lassen sie sich als strukturierte Umgebungen verstehen, die von erkennbaren sprachlichen Mustern geprägt sind. Die Ausgaben sind nicht willkürlich; sie spiegeln gelernte Beziehungen zwischen Sprache, Kontext und Wahrscheinlichkeit wider. Wo solche Muster existieren, wird strategische Interpretation möglich.
Dies hat erhebliche Auswirkungen auf das Reputationsmanagement. Da von künstlicher Intelligenz erzeugte Antworten zunehmend vermitteln, wie Organisationen, Marken und Einzelpersonen online dargestellt werden, gewinnt die Fähigkeit, diese Systeme zu verstehen und vorauszusehen, strategische Bedeutung. Dennoch besteht in der Branche nach wie vor eine deutliche Wissenslücke. Zwar führen viele Organisationen Werkzeuge der künstlichen Intelligenz ein, doch nur relativ wenige verfügen über ein detailliertes Verständnis davon, wie diese Systeme Informationen aufbauen und wiedergeben. Dadurch entsteht eine Kluft zwischen Nutzung und Erkenntnis, sodass der Umgang mit künstlicher Intelligenz eher reaktiv als strategisch bleibt.
Um diese Lücke zu schließen, muss man über oberflächliche Interaktion hinausgehen und sich direkter mit den Strukturen befassen, die der Sprachgenerierung selbst zugrunde liegen. Die Verarbeitung natürlicher Sprache umfasst ein breites Spektrum rechnergestützter Disziplinen, doch ihr Fundament bildet eine oft zu wenig genutzte Ressource: die linguistische Theorie. Bereiche wie Computerlinguistik, Semantik und Pragmatik liefern konzeptionelle Werkzeuge, um zu verstehen, wie Bedeutung, Interpretation und kontextuelle Beziehungen in Sprachsystemen kodiert werden. Dies sind keine abstrakten akademischen Fragen; sie sind unmittelbar relevant für die praktische Funktionsweise von LLMs.
Aktuelle Entwicklungen im Bereich der künstlichen Intelligenz verstärken diesen Zusammenhang zusätzlich. Bemühungen, kontextuelles Schlussfolgern zu bewerten und zu verbessern, Ausgaben enger an der menschlichen Absicht auszurichten und die Interpretationsgenauigkeit zu verfeinern, verweisen allesamt auf Herausforderungen, mit denen sich die Linguistik seit Langem befasst. Während sich Systeme generativer künstlicher Intelligenz zu immer ausgefeilteren Formen des Schlussfolgerns und der Kommunikation entwickeln, dürfte die Relevanz linguistischer Ansätze noch deutlicher hervortreten.
Für Organisationen, die in von künstlicher Intelligenz vermittelten Umgebungen agieren, verändert dieser Wandel das Wesen von Einfluss selbst. Es genügt nicht mehr, Kommunikation ausschließlich für menschliche Zielgruppen zu gestalten. Organisationen müssen zunehmend auch berücksichtigen, wie Informationen von Systemen generativer künstlicher Intelligenz verarbeitet, interpretiert und wiedergegeben werden. Dies bedeutet keine direkte Kontrolle über die Ausgaben. Vielmehr eröffnet es die Möglichkeit, strategischer mit den Strukturen zu arbeiten, über die diese Systeme Bedeutung erzeugen und Informationen priorisieren.
Bei Michael Macfarlane Associates prägt diese Perspektive unseren Ansatz für Reputationsstrategie in von künstlicher Intelligenz geprägten Umgebungen. Das Verständnis der sprachlichen Strukturen, die den Ausgaben von LLMs zugrunde liegen, ermöglicht eine präzisere Deutung dessen, wie Informationen in generativen Systemen entstehen, sichtbar werden und sich verfestigen. Da die durch künstliche Intelligenz gestützte Informationssuche immer stärker in den Alltag integriert wird, gewinnt dieses Verständnis zunehmend an Bedeutung für Organisationen, die in sich wandelnden digitalen Ökosystemen Glaubwürdigkeit und Autorität bewahren wollen.