语言学在大语言模型中日益重要
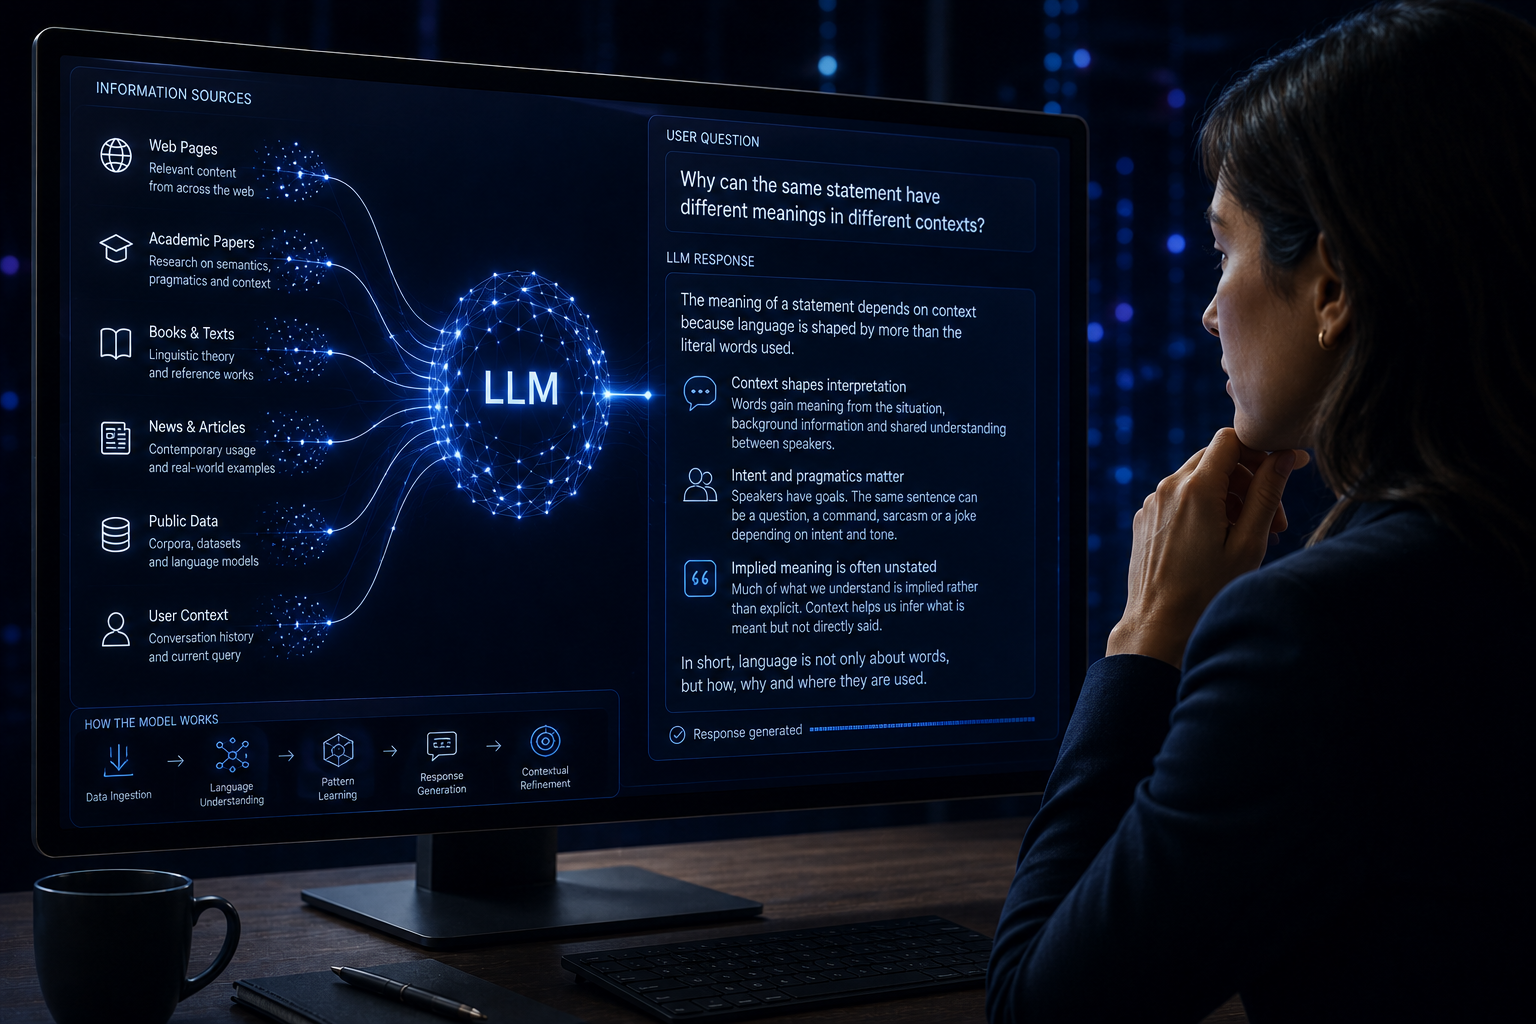
随着大语言模型不断发展,围绕意义、语境和诠释的诸多挑战日益指向语言学长期研究的问题,这使该学科成为理解人工智能驱动的语言系统之能力与局限的关键框架。
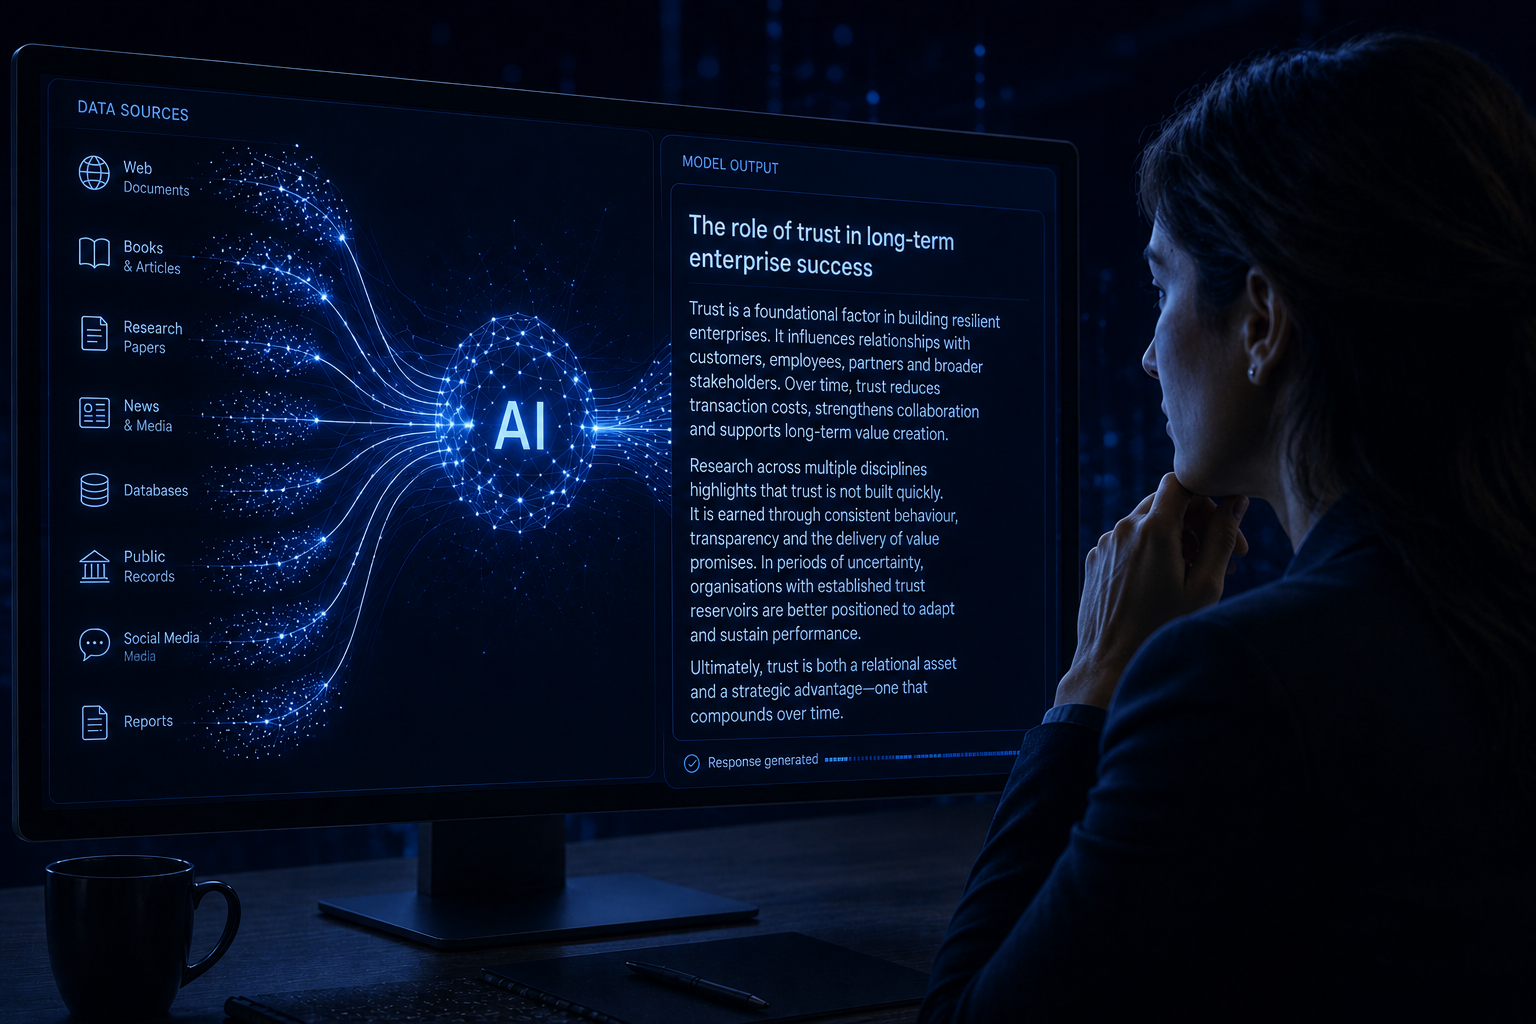
ChatGPT 等大语言模型(LLM)不仅日益影响哪些信息得以呈现,也日益影响数字环境中公信力与权威的构建方式。随着人工智能辅助搜索更深地融入日常事务,声誉管理也必须适应这一转变。
大语言模型隶属于更广泛的自然语言处理(NLP)领域,这一学科致力于使机器能够处理和生成人类语言。然而,尽管其影响力与日俱增,这些系统却常被称为“黑箱”:内部决策过程难以解读的不透明技术。它们的输出基于概率而非规则,是通过从海量数据中习得的模式生成的,而非依靠固定的推理结构。
各类组织往往主要在用户界面层面接触人工智能,专注于提示词、输出结果以及提示工程等表层交互方法,而对塑造这些系统的底层流程和架构关注甚少。尽管这些技巧可能带来渐进式改进,却鲜少触及意义形成和回答生成的深层机制。要理解这一过程,需要换一种视角:这种视角不仅立足于技术,更立足于语言本身。
从本质上看,大语言模型基于习得的意义、语境与结构之间的关系来预测语言序列。这种方法有利也有弊。这些模型在生成流畅、连贯的语言方面极为有效,但也可能误解细微差别、忽略隐含意义,或生成结构上看似令人信服、实则偏离意图的回答。这些局限并非随机出现。它们与语言学长期研究的领域密切对应。
例如,语义学探讨意义如何在语言中构建和表征。大语言模型通过词语和短语之间的统计关联来近似语义理解,但并不具备人类意义上的真正理解。因此,它们可能生成看似合理、却偶尔不准确、流于肤浅或语境不完整的回答。与此同时,语用学研究意义如何随语境、言外之意和共同认知而变化。在这方面,大语言模型同样依赖近似,这可能导致其难以诠释那些取决于情境意识或隐含意图、而非明确措辞的微妙之处。
理解这些语言层次,会改变人们对“黑箱”的看法。与其将人工智能系统视为完全不可知,不如将其理解为由可识别的语言模式塑造的结构化环境。输出并非随意产生;它们反映了语言、语境与概率之间习得的关系。凡有此类模式存在之处,策略性诠释便成为可能。
这对声誉管理具有重大意义。随着人工智能生成的回答日益左右组织、品牌和个人在网络上的呈现方式,理解和预判这些系统的能力在战略上变得至关重要。然而,该行业仍存在明显的知识缺口。尽管许多组织正在采用人工智能工具,但详细了解这些系统如何构建和复制信息的组织却相对较少。这造成了使用与洞察之间的脱节,使组织对人工智能的运用停留在被动应对而非战略层面。
弥合这一缺口,需要超越表层交互,更直接地研究支撑语言生成本身的结构。自然语言处理涵盖广泛的计算学科,但其根基在于一项常被低估的资源:语言学理论。计算语言学、语义学和语用学等领域提供了概念工具,有助于理解意义、诠释和语境关系如何编码于语言系统之中。这些并非抽象的学术问题;它们与大语言模型的实际运作直接相关。
人工智能领域的最新发展进一步强化了这种联系。评估并改进语境推理、使输出更贴合人类意图以及提升诠释准确性的种种努力,都指向语言学长期致力解决的挑战。随着生成式人工智能系统向日益复杂的推理与沟通形式演进,语言学框架的重要性可能会更加凸显。
对于在人工智能中介环境中运作的组织而言,这一转变改变了影响力本身的性质。仅为人类受众塑造传播内容已不再足够。组织日益需要考虑生成式人工智能系统如何处理、诠释和复制信息。这并不意味着能够直接控制输出。相反,这表明可以更具策略性地利用这些系统生成意义和排序信息所依托的结构。
在Michael Macfarlane Associates,这一视角指导着我们在人工智能驱动环境中开展声誉战略的方式。理解支撑大语言模型输出的语言结构,能够更精确地诠释信息如何在生成式系统中形成、呈现和强化。随着人工智能辅助的信息发现更深入地融入日常信息检索,这种理解程度对于寻求在不断演变的数字生态系统中保持公信力与权威的组织而言,正变得日益重要。