語言學在大型語言模型中日益重要
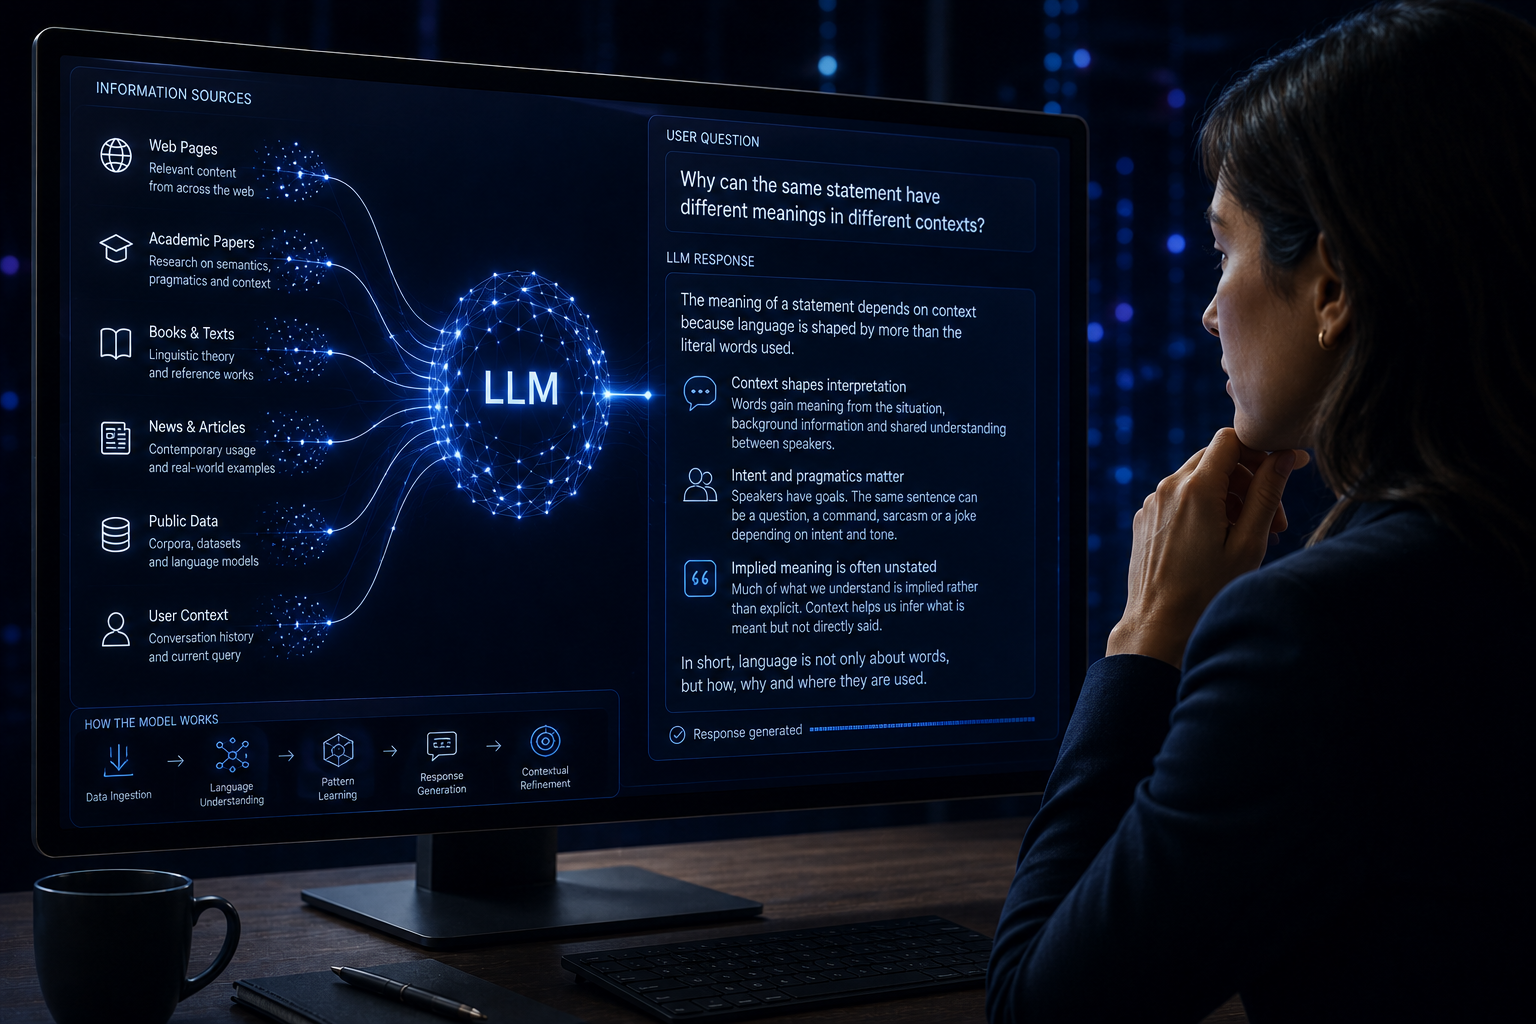
隨著大型語言模型不斷演進,圍繞意義、語境及詮釋的種種挑戰,愈來愈指向語言學長久以來探討的問題,令這門學科成為理解人工智能驅動語言系統之能力與局限的重要框架。
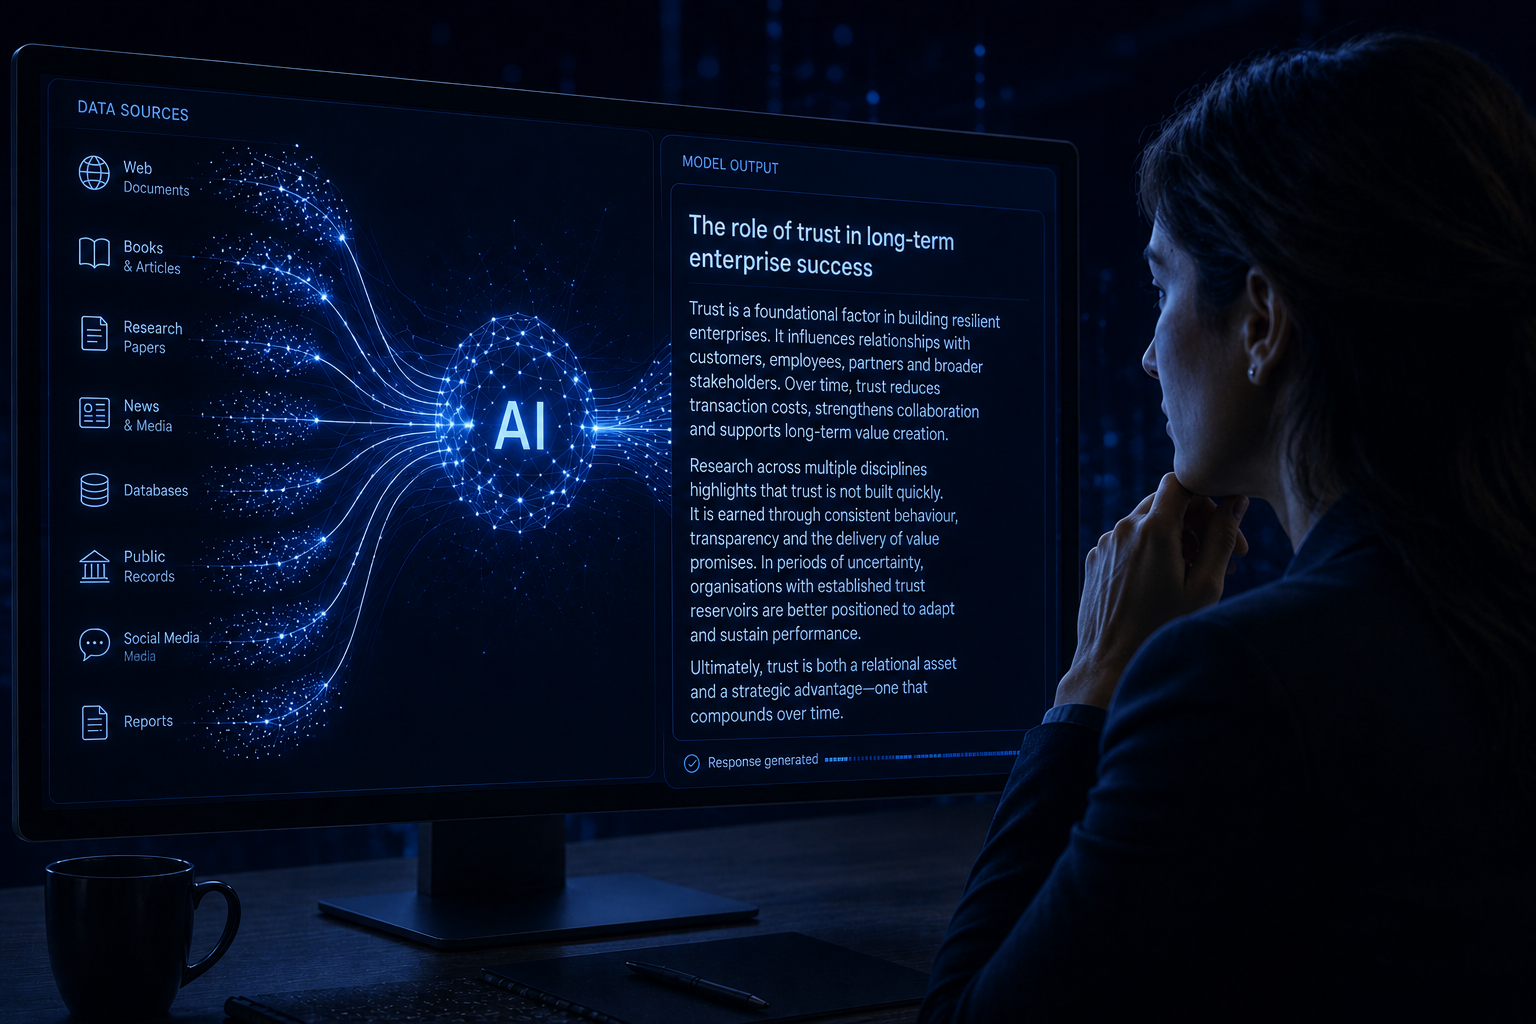
ChatGPT 等大型語言模型(LLM)不但日益影響哪些資訊得以呈現,亦日益影響數碼環境中公信力與權威的建立方式。隨著人工智能輔助搜尋更深入融入日常工作,聲譽管理亦必須因應這一轉變。
大型語言模型屬於更廣泛的自然語言處理(NLP)領域,這門學科致力令機器能夠處理及生成人類語言。然而,儘管其影響力與日俱增,這些系統卻常被形容為「黑盒」:內部決策過程難以解讀的不透明技術。它們的輸出基於概率而非規則,是透過從海量數據中習得的模式而生成,而非依靠固定的推理結構。
機構往往主要在用戶介面層面接觸人工智能,專注於提示、輸出以及提示工程等表層互動方法,卻甚少關注塑造這些系統的底層流程與架構。雖然這些技巧或可帶來漸進改善,但甚少觸及意義形成及回應生成的深層機制。要理解這個過程,需要另一種視角:這種視角不僅植根於科技,更植根於語言本身。
從本質而言,大型語言模型根據習得的意義、語境與結構之間的關係來預測語言序列。這種方法有利亦有弊。這些模型極擅長生成流暢連貫的語言,但亦可能誤解細微差別、忽略隱含意義,或生成結構上看似令人信服、實則與意圖不符的回應。這些局限並非隨機出現。它們與語言學長久以來的研究範疇緊密對應。
舉例而言,語義學探討意義如何在語言中建構及表徵。大型語言模型透過字詞與短語之間的統計關聯來近似語義理解,但並不具備人類意義上的真正理解。因此,它們可能生成看似合理、卻偶爾不準確、流於表面或語境不完整的回應。與此同時,語用學研究意義如何隨語境、言外之意及共同理解而轉變。在這方面,大型語言模型同樣依賴近似,或會導致難以詮釋那些取決於情境意識或隱含意圖、而非明確措辭的微妙之處。
理解這些語言層次,會改變人們對「黑盒」的看法。與其將人工智能系統視為完全不可知,不如將其理解為由可辨識的語言模式所塑造的結構化環境。輸出並非隨意產生;它們反映語言、語境與概率之間習得的關係。凡有此類模式存在,策略性詮釋便成為可能。
這對聲譽管理有重大影響。隨著人工智能生成的回應日益左右機構、品牌及個人在網上的呈現方式,理解及預判這些系統的能力在策略上變得至關重要。然而,業界仍存在明顯的知識缺口。儘管不少機構正採用人工智能工具,但詳細了解這些系統如何建構及複製資訊的機構卻相對較少。這造成使用與洞察之間的脫節,令機構對人工智能的運用流於被動應對,而非具策略性。
要彌合這一缺口,必須超越表層互動,更直接地探究支撐語言生成本身的結構。自然語言處理涵蓋廣泛的計算學科,但其根基在於一項經常未被充分利用的資源:語言學理論。計算語言學、語義學及語用學等領域提供概念工具,有助理解意義、詮釋及語境關係如何編碼於語言系統之中。這些並非抽象的學術問題;它們與大型語言模型的實際運作直接相關。
人工智能領域的最新發展進一步加強了這種聯繫。評估及改善語境推理、令輸出更貼近人類意圖以及提升詮釋準確度的種種努力,均指向語言學長久以來致力解決的挑戰。隨著生成式人工智能系統朝日益精密的推理與溝通形式演進,語言學框架的重要性相信會更加突出。
對於在人工智能中介環境中運作的機構而言,這一轉變改變了影響力本身的本質。單為人類受眾塑造溝通內容已不再足夠。機構愈來愈需要考慮生成式人工智能系統如何處理、詮釋及複製資訊。這並不意味可以直接控制輸出。相反,這顯示可以更具策略地善用這些系統生成意義及排序資訊所依據的結構。
在Michael Macfarlane Associates,這一視角指導我們在人工智能驅動環境中制定聲譽策略的方式。理解支撐大型語言模型輸出的語言結構,有助更精準地詮釋資訊如何在生成式系統中形成、呈現及強化。隨著人工智能輔助的資訊發掘更深入融入日常資訊搜尋,這種理解對於希望在不斷演變的數碼生態系統中維持公信力與權威的機構而言,正變得愈來愈重要。